
TRL documentation
TRL - Transformers Pekiştirmeli Öğrenme

TRL - Transformers Pekiştirmeli Öğrenme
TRL, Denetimli İnce Ayar (SFT), Grup Göreceli Politika Optimizasyonu (GRPO), Doğrudan Tercih Optimizasyonu (DPO), Ödül Modelleme gibi yöntemlerle dönüştürücü dil modelleri eğitmek için bir dizi araç sağladığımız tam yığın bir kütüphanedir. Kütüphane, 🤗 transformers ile entegre edilmiştir.
🎉 Yeni Neler Var
⚡ AsyncGRPOTrainer artık kararlı: AsyncGRPOTrainer kararlı API'ye yükseltildi. Üretimi eğitimden ayırarak GRPO'yu çok daha hızlı çalıştırır: bir vLLM sunucusu rollouts'ları akış halinde gönderirken eğitimci modeli günceller.
Taksonomi
Aşağıda, olgunluk ve yöntem türüne göre düzenlenmiş TRL eğitimcilerinin bir özeti yer almaktadır.
Deneysel
TRL ile ilgili modelleri, veri setlerini ve demoları TRL Hugging Face kuruluşunda da keşfedebilirsiniz.
Öğren
🤗 smol course ile TRL ve diğer kütüphanelerle eğitim sonrası öğrenin.
İçindekiler
Belgeler aşağıdaki bölümlere ayrılmıştır:
- Yeniden Başlangıç: kurulum ve hızlı başlangıç kılavuzu.
- Kavramsal Kılavuzlar: veri seti biçimleri, eğitim SSS ve günlükleri anlama.
- Nasıl Yapılır Kılavuzları: bellek kullanımını azaltma, eğitimi hızlandırma, eğitimi dağıtma vb.
- Entegrasyonlar: DeepSpeed, PEFT vb.
- Örnekler: örnek genel bakış, topluluk eğitimleri vb.
- API: eğitimciler, yardımcı programlar vb.
Blog yazıları
27 Mayıs 2026 tarihinde yayınlandı
Hub Kova ile Bir Trilyon Parametre Gönderimi: TRL'de Delta Ağırlık Senkronizasyonu

31 Mart 2026 tarihinde yayınlandı
TRL v1: Alanın Kendi Varsayımlarını Geçersiz Kıldığı Durumlarda Dayanıklılığını Koruyan Eğitim Sonrası Kütüphanesi
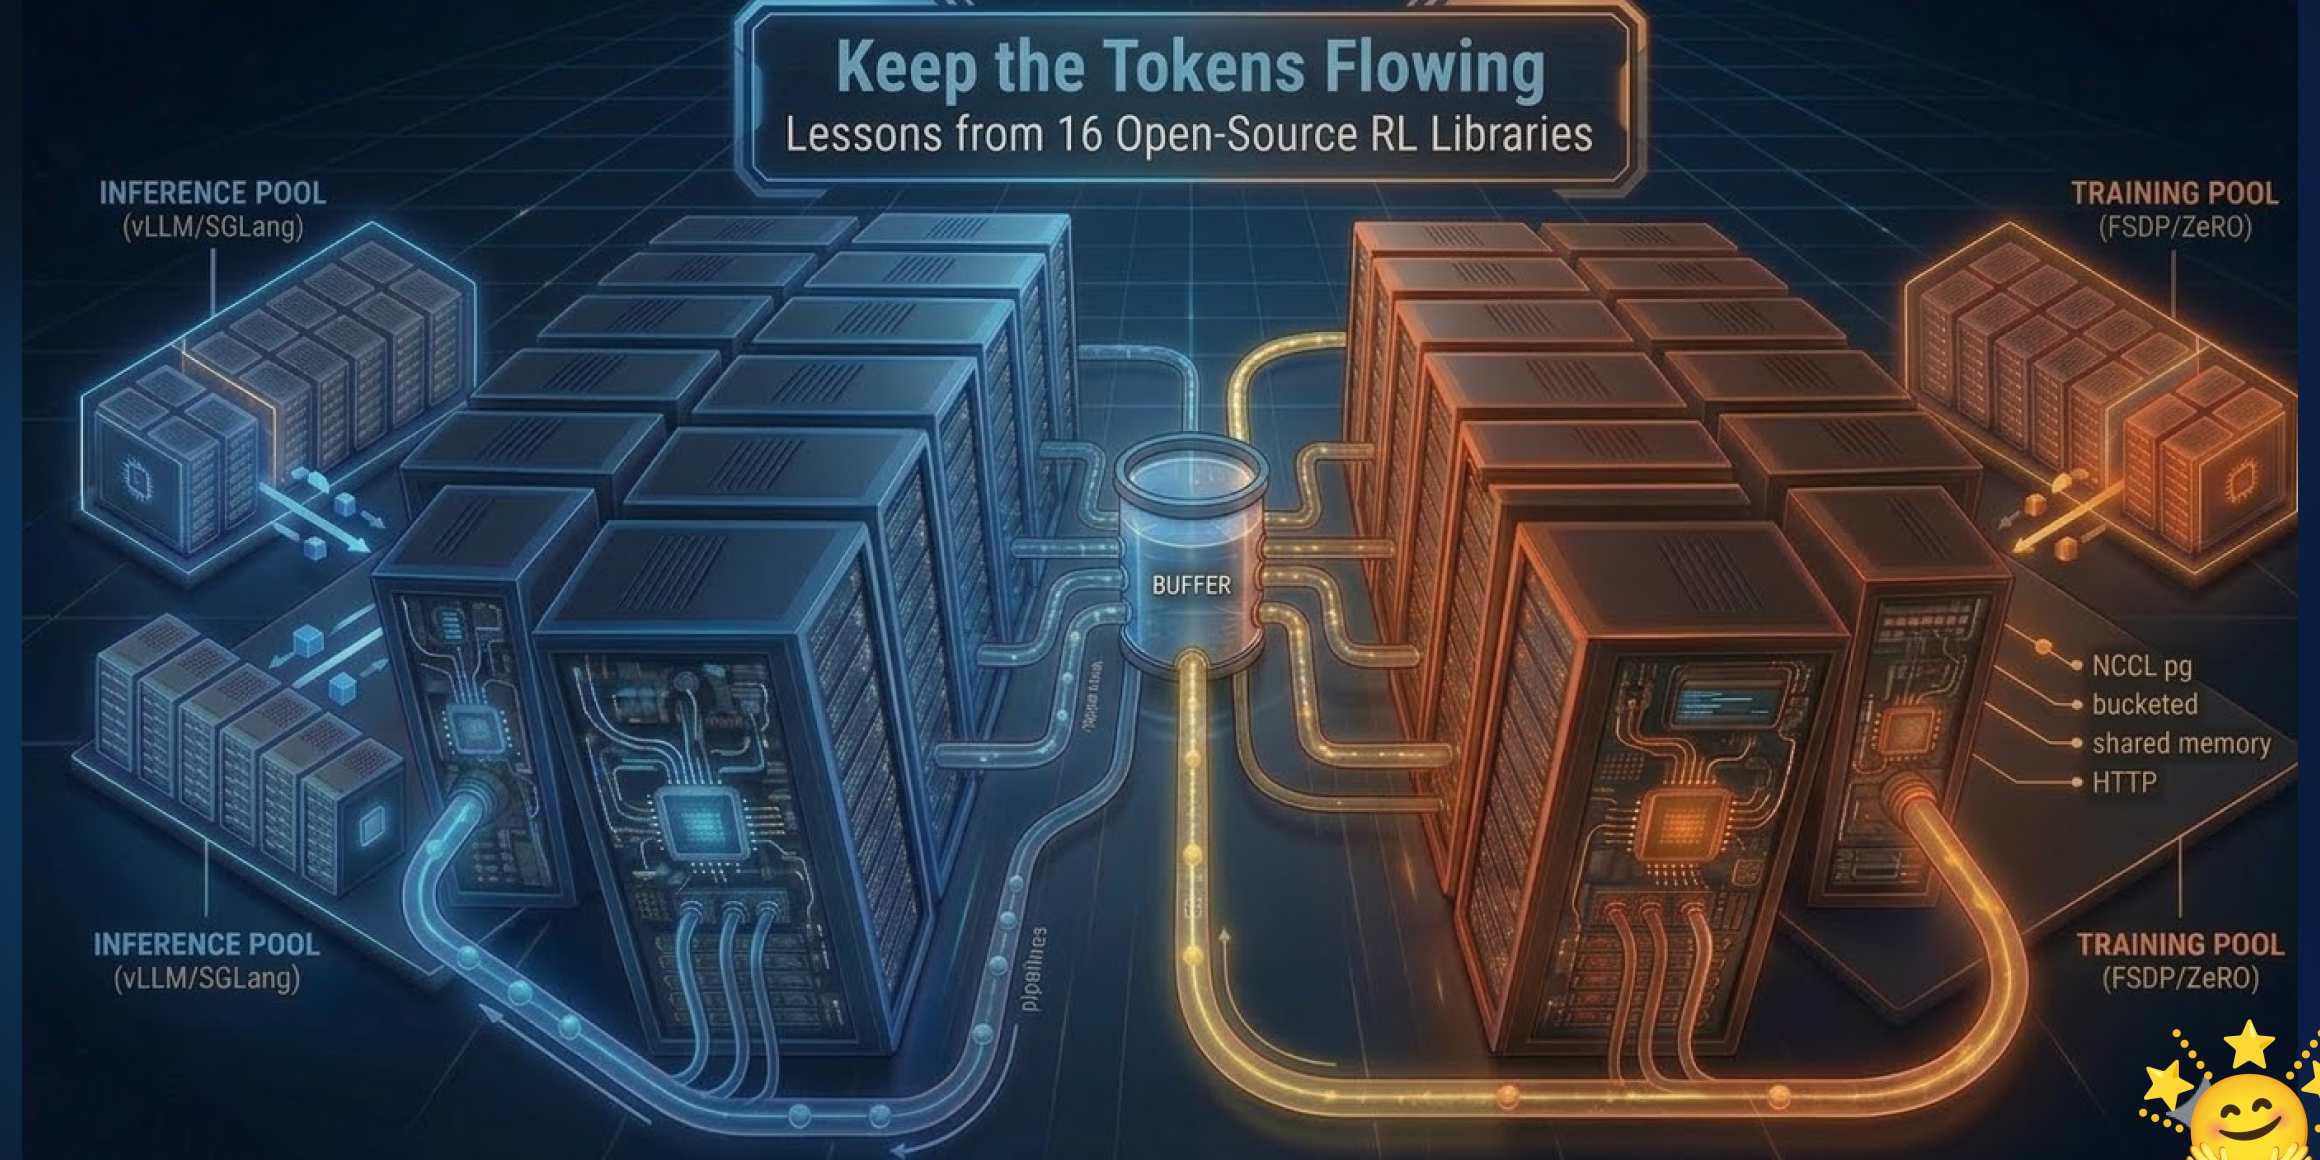
10 Mart 2026 tarihinde yayınlandı
Tokenların Akışını Sürdürün: 16 Açık Kaynak RL Kütüphanesinden Dersler
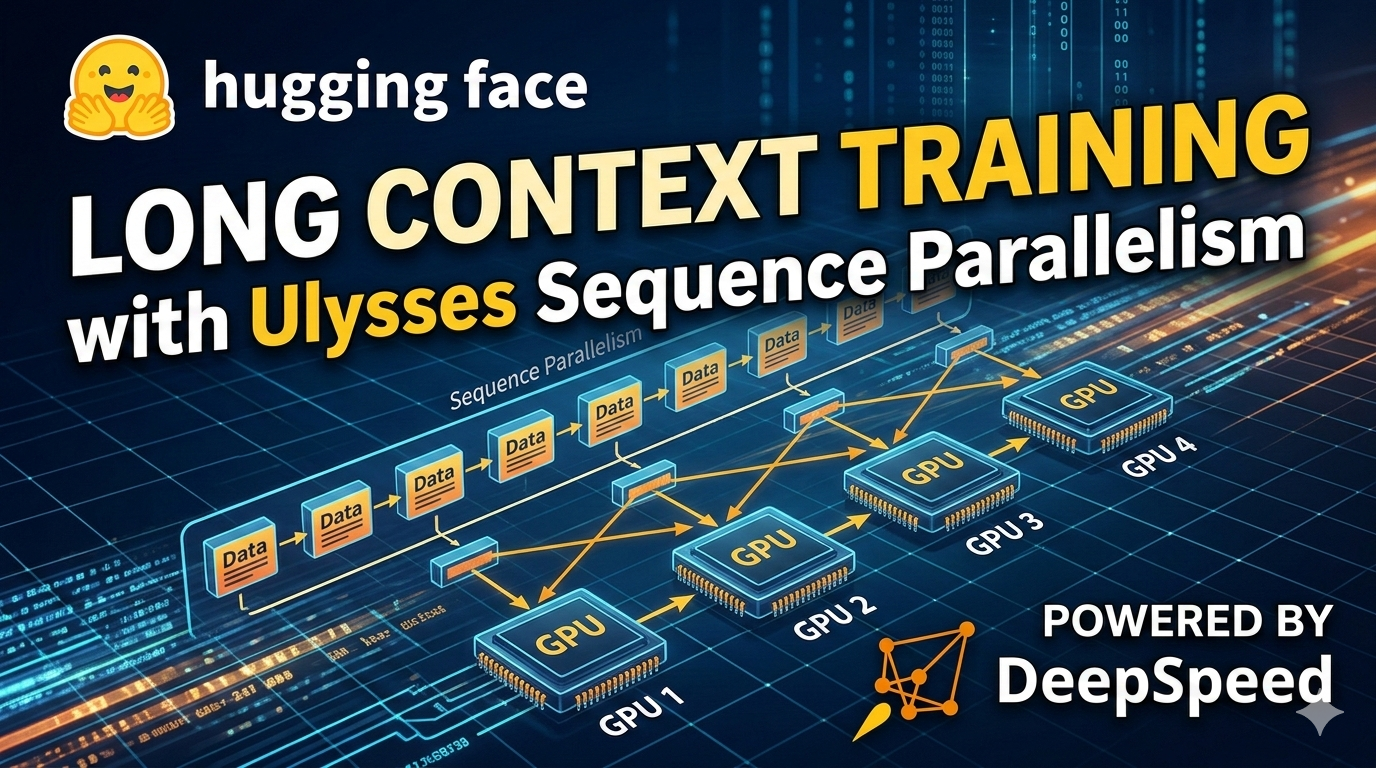
9 Mart 2026 tarihinde yayınlandı
Ulysses Sıralı Paralellik: Milyon Jetonlu Bağlamlarla Eğitim
23 Ekim 2025'te yayınlandı
Açık Ajan Ekosistemini Birlikte İnşa Ediyoruz: OpenEnv Tanıtımı
7 Ağustos 2025'te yayınlandı
TRL'de Görsel Dil Modeli Hizalama ⚡️
3 Haziran 2025'te yayınlandı
Hiçbir GPU geride kalmadı: TRL'de Birlikte Konumlandırılmış vLLM ile Verimliliği Açığa Çıkarma
25 Mayıs 2025'te yayınlandı
🐯 Liger GRPO, TRL ile buluşuyor
28 Ocak 2025'te yayınlandı
Open-R1: DeepSeek-R1'in tamamen açık yeniden üretimi
10 Temmuz 2024'te yayınlandı
TRL ile Görsel Dil Modelleri için Tercih Optimizasyonu
12 Haziran 2024'te yayınlandı
RLHF'e RL'yi geri getirmek
10 Ocak 2024'te yayınlandı
Unsloth ve 🤗 TRL ile LLM İnce Ayarını 2 kat hızlandırın
29 Eylül 2023'te yayınlandı
TRL ile DDPO Kullanarak Stable Diffusion Modellerini İnce Ayarlayın
8 Ağustos 2023'te yayınlandı
Llama 2'yi DPO ile ince ayar yapın
5 Nisan 2023'te yayınlandı
StackLLaMA: RLHF ile LLaMA eğitmeye yönelik uygulamalı bir kılavuz
9 Mart 2023'te yayınlandı
24 GB'lik tüketici GPU'sunda RLHF ile 20B LLM'lerin ince ayarı
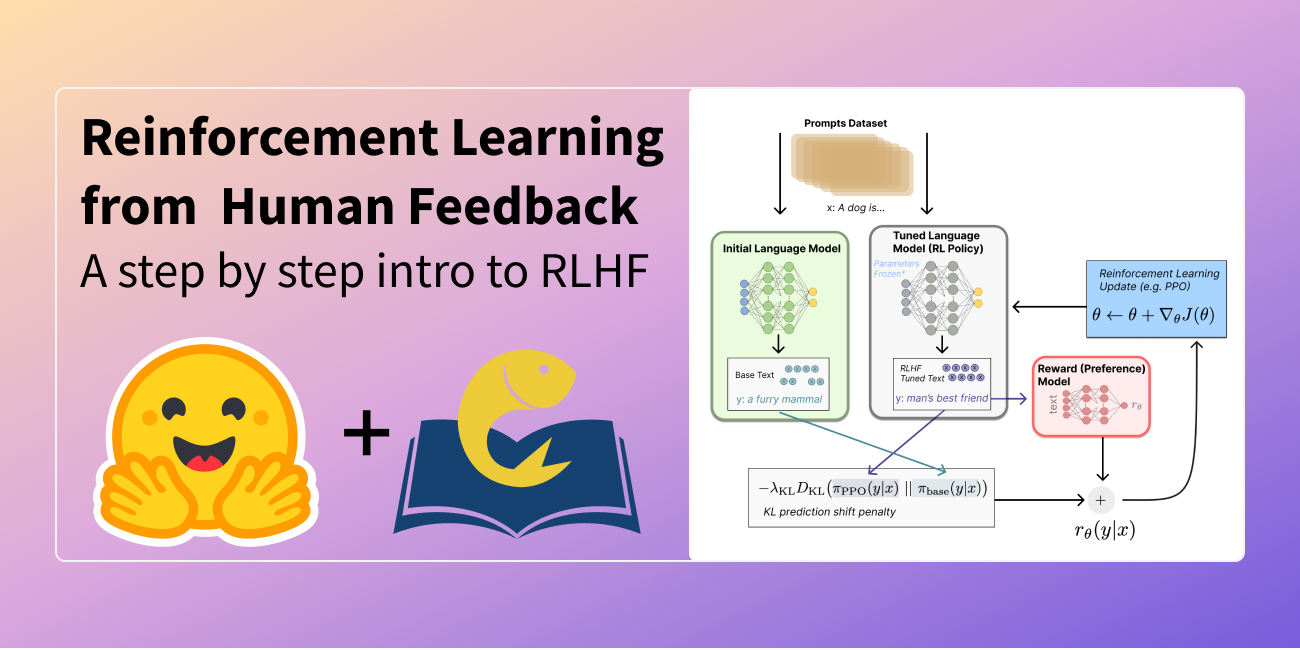
9 Aralık 2022 tarihinde yayınlandı
İnsan Geri Bildiriminden Pekiştirmeli Öğrenmenin Görselleştirilmesi
